客户端最佳实践
社区译文;来源: MCP 80041ab0
当 Agent 等 MCP 宿主应用连接越来越多的 MCP 服务器,并逐渐获得数百甚至数千个工具的访问权限时,朴素的工具管理方式就会失效。预先把所有工具定义加载到模型上下文窗口中,会浪费 token、增加延迟并降低模型性能;在连续工具调用之间通过模型传递大量中间结果,则会进一步放大这些问题。
有两种模式可以应对这些挑战:渐进式发现控制工具定义在_何时_进入上下文,程序化工具调用控制工具_如何_被调用。
渐进式工具发现
朴素的 MCP 宿主实现在每次对话开始时,会将所有已连接服务器的工具定义直接传给模型。只有少量工具时,这种做法完全合理;但当宿主可以访问数十台服务器提供的数百个工具时,仅这些定义就可能在模型读取用户消息前占用上下文窗口的大部分空间。
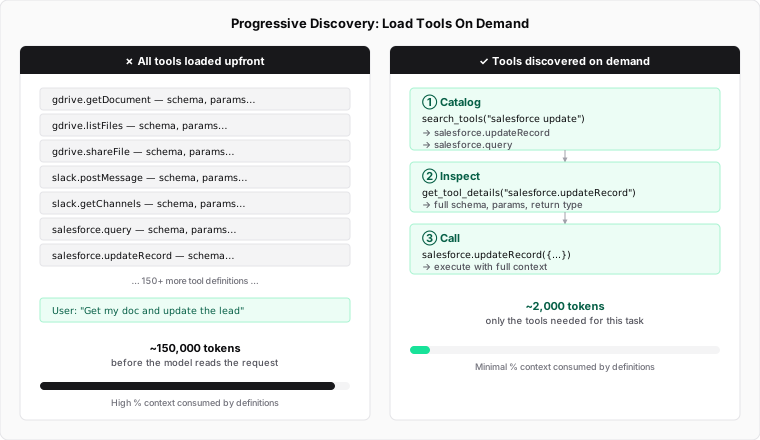
渐进式发现通过以下方式避免该问题:
- 宿主照常通过
tools/list获取工具定义,但推迟将其注入模型上下文。 - 宿主向模型提供一个轻量的
search_tools元工具。 - 宿主只在需要时将完整定义加载到上下文。
何时使用渐进式发现
当工具定义占用上下文窗口的较大部分时,最适合使用渐进式发现。对于定义只占很小空间的少量工具,直接加载全部工具即可。一旦工具定义占用了可用上下文窗口的显著部分,客户端就应切换到渐进式发现。建议客户端实现阈值来决定切换时机:
- 将阈值设为上下文窗口的百分比,例如 1%-5%。
- 加载工具定义;达到阈值后切换到渐进式发现。
选择发现策略
模型调用 search_tools 后,需要选择一种搜索策略:
- 基于关键字:使用 BM25、正则表达式等进行关键字匹配。方式简单且有效,尤其适用于描述清晰的工具名称和说明。
- 基于嵌入:对工具描述进行向量相似度检索,能更好地处理同义词和语义匹配。
- 基于子 Agent:由次级模型选择任务所需工具,通常使用 Claude Haiku 或 Gemini Flash 等小型快速模型。效果通常很好,但成本可能高于嵌入或关键字方案。
- 混合策略:组合多种方法,例如综合关键字和嵌入排名评分,或根据用例、查询选择不同策略。
部分模型提供商已内置工具搜索。例如,OpenAI 和 Anthropic 原生支持该能力;请查看你的提供商是否有等效功能。可用时,可以优先使用平台的工具搜索;若提供商未提供,或你需要领域专用排名、访问控制过滤等特殊检索逻辑,再自行实现。
下面的三层模式详细展示了自定义搜索方案。无论使用哪种检索机制,其“目录、检查、执行”的分层原则都适用。
使用渐进式发现
渐进式发现的一种常见实现是基于搜索的三层方案:
第 1 层:目录。 宿主暴露一小组用于搜索可用能力的元工具。search_tools 接受自然语言查询,返回匹配的工具名称和简短说明。
// The model calls a lightweight search tool
search_tools({ query: "update salesforce record" })

// Returns concise matches: names and one-line descriptions only
→ [
    { name: "salesforce_updateRecord", description: "Update fields on a Salesforce object" },
    { name: "salesforce_upsertRecord", description: "Insert or update based on external ID" }
  ]
第 2 层:检查。 模型识别出候选项后,只获取该工具的完整定义,包括输入 schema、输出 schema 和文档。
// The model inspects only the tool it needs
get_tool_details({ name: "salesforce_updateRecord" });
该调用返回单个工具的完整 schema:
{
  "name": "salesforce_updateRecord",
  "description": "Updates a record in Salesforce",
  "inputSchema": {
    "type": "object",
    "properties": {
      "objectType": {
        "type": "string",
        "description": "Salesforce object type"
      },
      "recordId": { "type": "string", "description": "Record ID to update" },
      "data": { "type": "object", "description": "Fields to update" }
    },
    "required": ["objectType", "recordId", "data"]
  }
}
第 3 层:执行。 模型在充分了解接口后调用工具,且只加载了所需定义。
该模式可大幅减少 token 使用量并提高工具选择准确性:模型只需关注少数相关工具,而不是扫描数百个无关工具。嵌入、子 Agent 等其他发现策略也遵循相同的分层原则,只是在目录层使用不同的检索机制。
动态服务器管理
渐进式发现还可从单个工具扩展到整个服务器。宿主无需在启动时连接所有已配置服务器,而可以:
- 维护可用服务器及其高层描述的注册表。
- 只在模型判断需要某台服务器的能力时连接它。
- 断开与当前任务不再相关的服务器,释放上下文空间。
  sequenceDiagram
    participant Model
    participant Host
    participant Registry
    participant Server

    Model->>Host: search_available_servers("CRM")
    Host->>Registry: Query available servers
    Registry-->>Host: Salesforce server (not connected)
    Host-->>Model: Salesforce server available

    Model->>Host: enable_server("salesforce")
    Host->>Server: server/discover
    Server-->>Host: Supported versions + capabilities
    Host->>Server: tools/list
    Server-->>Host: Tool definitions
    Host-->>Model: Salesforce server connected

    Note over Model: Task complete

    Model->>Host: disable_server("salesforce")
    Host-->>Model: Server disconnected, context freed
这特别适合通用 Agent,因为启动时通常还不知道用户意图。Agent 可以只启用一组最小的常驻服务器,并按需连接其他服务器。结合 Agent Skills 使用时,Skill 文件可以声明所需的 MCP 服务器,宿主只在该 Skill 被调用时连接它们。
实现指南
实现渐进式发现时:
| 指南 | 理由 |
|---|---|
| 提供多种详细程度 | 让模型选择只返回名称、名称与描述,或完整 schema。 |
| 缓存工具定义 | 从服务器获取定义后,在宿主侧记忆化,使后续重新注入不必再次往返调用 tools/list。这与定义当前是否位于模型上下文中是两回事。 |
收到 list_changed 时刷新 | 服务器发送 notifications/tools/list_changed 后,重新索引搜索目录。 |
| 按服务器分组工具 | 按来源服务器组织工具,让模型能够推断相关能力。 |
缓存
每个列表结果(例如 tools/list)、每个 server/discover 结果和每个 resources/read 结果都带有 ttlMs 与 cacheScope 提示。请遵循规范的缓存工具定义。尤其要注意:一旦收到 list_changed 通知,即使 TTL 尚未到期,也应将缓存列表视为过期。
与提示词缓存的交互
多数提供商会缓存提示词前缀,其中包括 tools 数组。在对话中途添加或删除工具定义会使该缓存失效,导致一次缓存未命中,其 token 成本可能高于已移除的定义。为了保留缓存:
- 将新发现的定义追加到缓存断点之后,不要重新排序
tools数组;或者让所有调用都通过一个稳定的call_tool({name, args})元工具,使该数组保持不变。 - 将断开服务器连接视为对话边界操作,而不是每轮都执行的操作。
- 将提供商的缓存文档与上文工具搜索链接结合查阅。
程序化工具调用 / Code Mode
直接调用工具时,每次调用都需要一次往返:模型生成工具调用,客户端执行它,完整结果再流回模型上下文。当任务需要串联多个工具,例如读取文档、转换内容再写入其他位置时,每个中间结果都会经过模型,即使模型无需处理这些数据,也会消耗 token 并增加延迟。
程序化工具调用有时也称为“code mode”,它让客户端可以有效地组合工具调用。模型不再直接调用工具,而是编写调用工具的代码。代码在沙箱环境中执行,只有最终结果返回模型。
程序化工具调用功能强大,可以更高效地使用 MCP 工具和资源,但客户端必须实现沙箱环境。
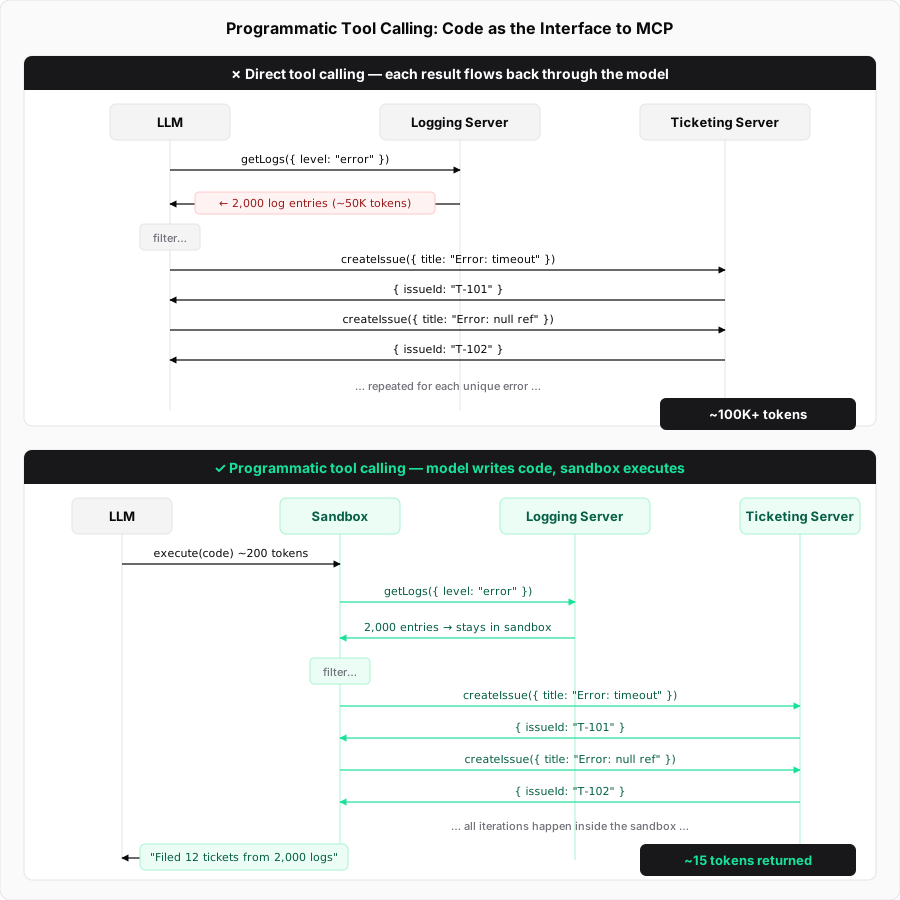
工作原理
宿主将 MCP 工具 schema 转换为沙箱中可用的类型化 API。模型需要使用工具时,会编写并执行脚本。
第 1 步:从 MCP schema 生成程序化 API。 宿主读取每台服务器的工具定义,并根据工具参数和 outputSchema 生成类型化函数:
// Auto-generated from the Logging MCP server's tool schema
interface LogEntry {
  timestamp: string;
  message: string;
  level: string;
}

function logging_getLogs(input: {
  level: "error" | "warn" | "info";
  since: number;
}): Promise<{ entries: LogEntry[] }> {
  return mcp.callTool<{ entries: LogEntry[] }>("logging_getLogs", input);
}

// Auto-generated from the Ticketing MCP server's tool schema
function ticketing_createIssue(input: {
  title: string;
  body?: string;
  priority: "low" | "medium" | "high";
}): Promise<{ issueId: string }> {
  return mcp.callTool<{ issueId: string }>("ticketing_createIssue", input);
}
MCP 服务器可以为每个工具提供可选的 outputSchema。存在输出 schema 时,宿主可以生成精确的返回类型,例如上面的 LogEntry。
没有输出 schema 时,应优先选择简单方案:
- 使用通用类型并继续。 接受
any或string,并在下游处理非结构化输出。真正的解决方式是让服务器作者提供outputSchema。 - 使用快速模型提取类型化结果,适用于循环之外的单次调用。通过与 MCP 工具调用相同的 stub 拦截路径,提供由宿主代理的
extract(value, ExpectedType)辅助函数,确保沙箱本身不打开网络连接。该辅助函数将值路由到小型模型(例如 Claude Haiku 或 Gemini Flash),转换为ExpectedType。这会增加每次调用的延迟,并可能产生幻觉或遗漏字段,因此使用前必须按ExpectedType验证结果。
第 2 步:模型针对这些 API 编写代码。 模型无需连续发出独立工具调用,并让完整结果在各次调用间流经上下文,而是编写单个脚本。以“查找过去一小时的所有错误日志,并为每个不同错误创建工单”为例:直接调用会让数千条日志进入模型上下文;使用代码时,模型可在沙箱中完成过滤:
// Model-generated code, executes in sandbox
const logs = await logging_getLogs({
  level: "error",
  since: Date.now() - 3600000,
});

// Filter and deduplicate inside the sandbox, not in the model's context
const uniqueErrors = new Map<string, LogEntry>();
for (const log of logs.entries) {
  if (!uniqueErrors.has(log.message)) {
    uniqueErrors.set(log.message, log);
  }
}

for (const [message, log] of uniqueErrors) {
  await ticketing_createIssue({
    title: `Error: ${message}`,
    body: `First seen: ${log.timestamp}\nOccurrences: ${
      logs.entries.filter((l) => l.message === message).length
    }`,
    priority: "high",
  });
}

console.log(
  `Filed ${uniqueErrors.size} tickets from ${logs.entries.length} error logs`,
);
第 3 步:沙箱执行代码。 沙箱中的函数调用会被拦截,并通过宿主代理路由到对应的 MCP 服务器。日志数据和工单创建请求在服务器之间直接流转,不会进入模型上下文。只有 console.log 输出的一行摘要返回模型。
选择沙箱
合适的沙箱取决于你希望模型编写的语言、宿主应用的实现语言,以及所需隔离强度。下表列出的是运行时示例,而非产品背书;请根据用例评估其成熟度:
| 沙箱语言 | 运行时 / 库 | 宿主语言 | 方式 |
|---|---|---|---|
| JavaScript | Deno、isolated-vm | Rust / Node / CLI | 基于 V8 的运行时,支持细粒度权限;可以禁用所有权限以实现完全锁定。 |
| Python | Monty (实验性) | Rust | 为 AI 用例构建的最小 Python 解释器,默认无 I/O。 |
| TypeScript | pctx (早期阶段) | Python / Rust | 以库的形式整合 code mode 概念,并提供底层 Rust 支持。 |
| 任意语言(Wasm) | Wasmtime | Rust / C / Go | 将任意语言编译为 Wasm,并使用基于能力的安全模型运行。 |
无论选择哪种沙箱,集成模式都相同:宿主注入函数 stub,通过进程内或 stdio 通道拦截调用,从而可始终完全禁用网络权限,再将调用分发为对 MCP 服务器的 tools/call 请求。
执行架构
该实现包含三个组件:
  flowchart LR
    subgraph Host["MCP Host"]
        A[LLM] -->|writes code| B[Sandbox]
        B -->|function call| C[MCP Client]
        C -->|return value| B
        B -->|console output| A
    end
    C -->|tool call| D[MCP Server A]
    C -->|tool call| E[MCP Server B]
    D -->|result| C
    E -->|result| C
沙箱在隔离环境中运行模型生成的代码,且不能直接访问网络。它与外界的唯一接口是生成的函数 stub,这些 stub 会将调用路由回宿主。
宿主充当代理。它接收来自沙箱的函数调用,将其映射到正确的 MCP 服务器,执行工具调用,并将结果返回沙箱。授权令牌和凭据由宿主持有,绝不会暴露给生成的代码。
模型只能看到沙箱返回的内容,通常是 console.log 语句的输出或最终返回值。模型和客户端开发者因此可以精确控制哪些内容进入上下文窗口。
安全注意事项
程序化工具调用引入了代码执行面,需要谨慎实施沙箱:
- 逐调用授权:从规范角度看,代理仍是 MCP 宿主。对沙箱发起的调用应用与直接调用相同的人工确认策略,参见工具:安全。批准脚本并不等于自动批准它在运行时发出的每个工具调用。宿主可以授予分类许可,例如“本次脚本运行允许
ticketing_createIssue”,而不必在每次迭代时提示,但代理仍必须根据该许可检查每次调用。 - 跨服务器数据流:来自一台服务器的工具结果,对另一台服务器而言是不可信输入。代理应对中转调用应用与直接调用相同的输入审查策略;仅截断输出不能阻止数据外泄。
- 网络隔离:沙箱不应拥有直接网络访问权限。所有外部通信都应经过执行授权和访问控制的宿主代理。
- 不暴露凭据:API 密钥和令牌由宿主持有。生成的代码调用类型化函数,宿主在转发到服务器时添加身份验证信息。
- 资源限制:为沙箱执行设置超时和内存限制,防止脚本失控。
- 输出过滤:将沙箱控制台输出反馈给模型前,先进行验证和截断。
错误处理
MCP 工具错误会以带有 isError: true 的成功响应返回,而不是传输失败。生成的 wrapper 应将其转换为抛出的异常,使模型编写的代码可以使用 try/catch。如果未捕获的错误终止脚本,应将错误作为脚本结果提供给模型,使其能够自行修正;模型负责报告已实际发生的任何部分副作用。
组合使用两种模式
渐进式发现和程序化工具调用可以很好地配合。模型先使用发现工具识别所需工具并加载其 schema,然后编写单个脚本,在一次执行中调用多个工具。这种组合既能减少工具定义的 token 成本,也能减少工具结果的 token 成本,使模型上下文专注于推理,而不是传递数据。